先看 1 分鐘示範影片
這支影片就是 crv 實際工作的畫面錄影,下面每個功能都會拆開講:
功能一:場景感知抽幀牆免費版就有
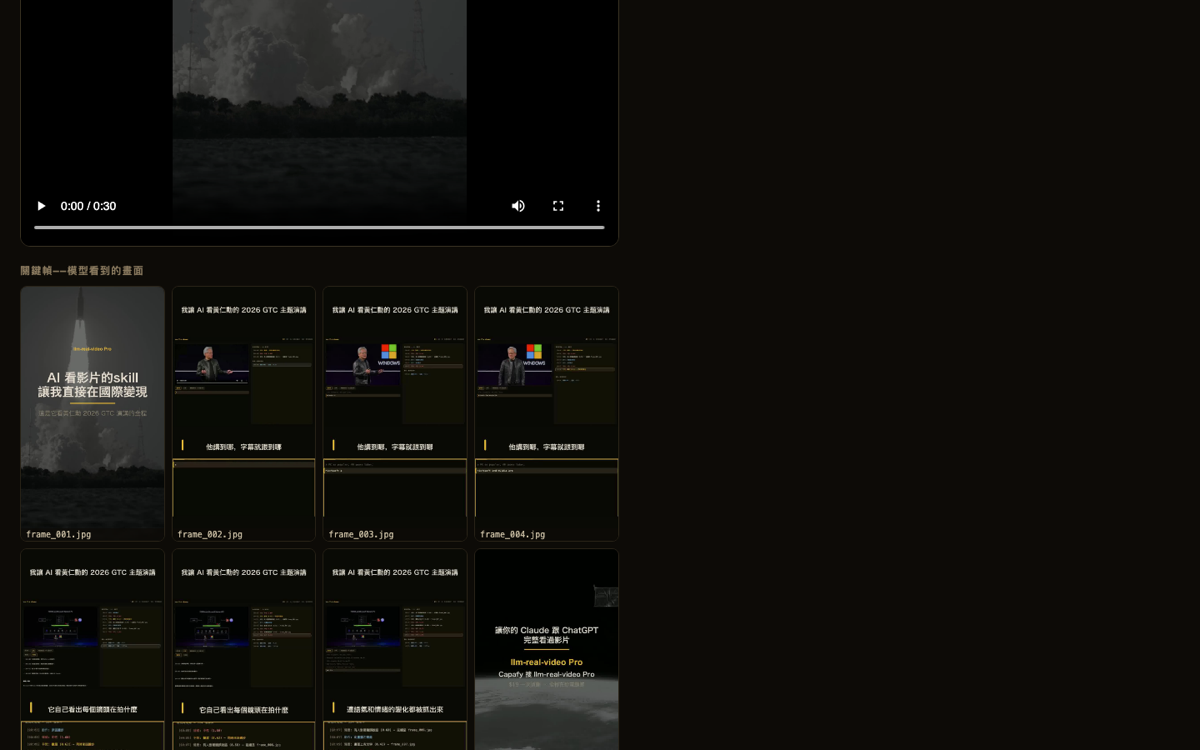
一般做法是死板地「每秒抽一張」,一支 10 分鐘影片會抽出 600 張圖。crv 只在「畫面真的變了」的時候抽,再自動去掉重複——同一支影片通常只剩 20-60 張,餵給 AI 的成本直接砍九成,而且該在的畫面一張不少。抽完會生成一面關鍵幀牆,你一眼就能看到「AI 看到了哪些畫面」:
功能二:逐字稿跟著影片跑免費版就有
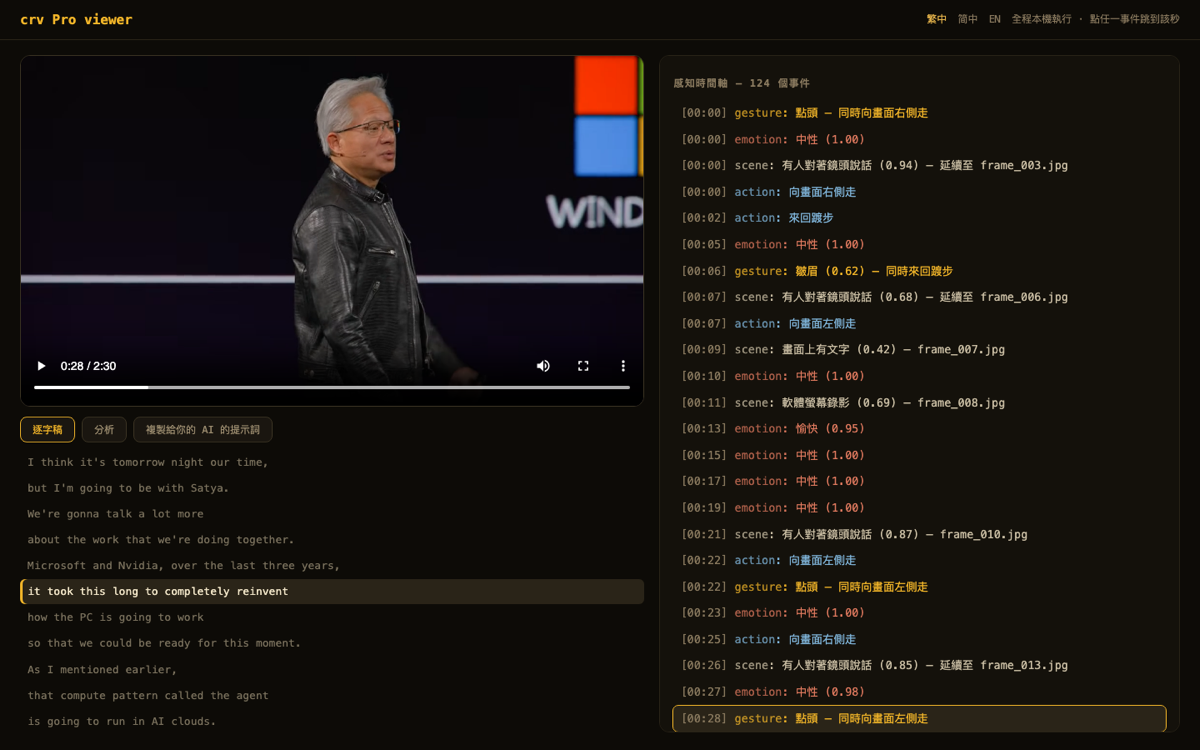
語音用 Whisper 在本機轉成逐字稿,而且每一句都帶時間戳。在 viewer 裡按播放,講到哪一句、哪一句就亮起來;點任何一句,影片直接跳到那一秒。你要找「他講某句話是第幾分鐘」,再也不用來回拖進度條:
功能三:感知時間軸Pro
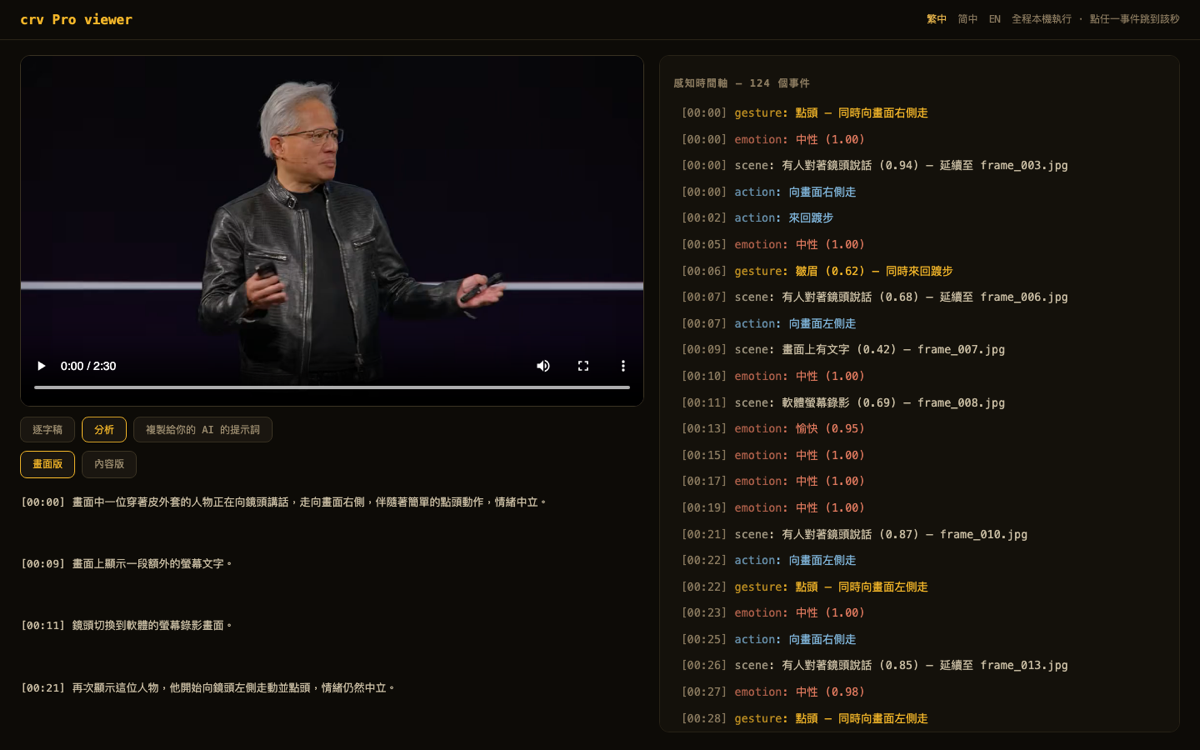
這是 Pro 版的招牌,也是上面截圖右半邊那一排:把「畫格看不到的東西」全部排上時間軸——哪一秒他開始踱步、哪一秒點頭、哪一秒語氣從中性變愉快、鏡頭什麼時候推近拉遠、剪接節奏是快是慢。黃仁勳這支 2 分半的影片,它標出了 124 個感知事件。拆解別人的爆紅影片為什麼抓人,看的就是這一層。
功能四:AI 自動分析報告Pro
分析完不用自己拼結論——它直接寫給你兩份報告:「畫面版」逐段講畫面上發生什麼,「內容版」講這支影片在說什麼、哪些點值得查證。報告就在 viewer 的分析分頁裡,也存成檔案方便丟給任何 AI 接著用:
功能五:MCP 直連你的 AI 工具免費版就有
0.8.0 起,crv 也是一個 MCP server。裝好之後,在 Claude Code、Claude Desktop、Cursor 這些支援 MCP 的工具裡,AI 可以直接說「幫我看這支影片」——關鍵幀和逐字稿自動送進對話,不用自己跑指令再貼檔案。安裝一行:pip install 'claude-real-video[mcp]',同一支影片問第二個問題時用快取、幾乎秒回。
功能六:畫面文字辨識(OCR)Pro
影片裡的字幕、字卡、招牌,全部變成帶時間戳、可引用、可搜尋的文字。聽寫聽錯的人名、數字、術語,由畫面上的原字幕當場糾正——短影音滿屏字卡,每一張都成了資料。中日韓文辨識特別強,全程在你的電腦上跑。
功能七:跨影片記憶搜尋Pro
Pro 看過的每一支影片,都進到你電腦上同一個可搜尋的索引。用一句話問——哪支影片講過、第幾秒、原句是什麼,中英文都查得到。再問只有 Pro 答得出來的:找出你看過的所有推鏡片段、找出聲音模型標到情緒的時刻、把整個片庫按剪接密度排名。看過的影片再跑一次幾乎秒回,直接指回既有分析不重跑。一個檔案存在你機器上,什麼都不上傳。
功能八:速度鑑識Pro
逐段檢出影片時間軸被動過的手腳。多重訊號交叉驗證——墊幀指紋、運動軌跡連續性、以人為基準的速度時鐘——逐段標出慢放墊幀、後製加速與縮時拍攝,並附證據等級。設計上誠實到底:只報告證據、永遠不說「這是正常速度」,內建融合規則讓激烈運動和遊戲畫面不被冤枉。上線前經過三輪真人盲測驗收。
還有幾個常被問的
隱私:影片解析與輸出生成都在你的電腦完成,原始影片不會上傳;你之後選擇貼給雲端 AI 的畫格或逐字稿,才會傳給該服務。
相容性:輸出就是一個資料夾(圖+文字),Claude、ChatGPT、Gemini、你自己架的開源模型都讀得懂。
成績單:我們把 crv 和「每秒抽一張」的公開對照實驗(含失敗案例)放在 GitHub 的 benchmark 資料夾,任何人都能自己重跑驗證。